Qu’est-ce que la cannibalisation SEO ?
La cannibalisation SEO, c’est quand plusieurs pages de votre propre site se positionnent sur une même requête Google et répondent à la même intention de recherche. Au lieu d’avoir une page forte, vous en avez deux (voire plus) qui se partagent les miettes. Vos pages se mangent entre elles, d’où le nom.
Prenons un exemple concret : vous êtes artisan en rénovation énergétique et vous avez publié en 2023 un article « Comment isoler ses combles ? ». Deux ans plus tard, vous écrivez « Isolation des combles : le guide complet » en pensant bien faire. Résultat : Google ne sait plus quelle page proposer sur « isolation combles » et vous vous retrouvez en 14e et 18e position au lieu d’une belle 5e place. Deux articles rédigés, zéro clic !
L’intention de recherche, le vrai critère
Attention, deux pages qui ressortent sur le même mot-clé ne sont pas forcément en concurrence. Ce qui compte, c’est ce que l’internaute cherche réellement.
Reprenons notre artisan. Une page service « Isolation des combles à La Rochelle » vise quelqu’un qui veut un devis. Un article « Comment isoler ses combles soi-même ? » vise un bricoleur qui veut faire le travail lui-même. Le mot-clé est proche, l’intention est complètement différente : ces 2 pages peuvent tout à fait cohabiter.
Mon conseil pour trancher : tapez la requête dans Google et regardez la première page. Si Google affiche à la fois des pages d’entreprises et des tutoriels, il considère que les deux intentions existent. Si vous ne voyez que des guides, vos 2 articles se battent pour la même place.
Quelles conséquences pour votre SEO ?
Concrètement, voici ce que la cannibalisation vous fait perdre :
- Jus SEO dilué : les backlinks et les liens internes sont répartis entre plusieurs pages au lieu de renforcer une seule URL. Si vous avez acheté un lien à 150€ vers une page que Google ne met pas en avant, c’est de l’argent jeté par la fenêtre (comme nous l’avons vu dans notre article sur le netlinking, un lien doit pointer vers la bonne page).
- Positions en yo-yo : Google alterne entre vos URL, une semaine c’est l’une, la semaine suivante c’est l’autre. Aucune ne se stabilise.
- CTR en berne : une page en 2e page Google, personne ne clique dessus. Deux pages en 2e page non plus !
- Budget de crawl gaspillé : Google passe du temps sur des pages qui se ressemblent. Pour un site vitrine de 30 pages, ce n’est pas le premier souci, pour un e-commerce de 5 000 produits, c’est une autre histoire.
- Temps de rédaction perdu : vous avez payé (ou passé du temps sur) deux contenus pour un résultat inférieur à celui d’un seul.
La cannibalisation n’est pas toujours un problème
Je le précise car beaucoup de SEO voient de la cannibalisation partout. Si deux de vos pages sont en 3e et 5e position sur un même mot-clé, vous occupez plus de place dans les résultats que vos concurrents. Là, il ne faut surtout rien toucher !
Le vrai signal d’alerte, c’est quand aucune de vos pages ne décolle alors que le contenu est de qualité et que le site a de la puissance. Nous verrons plus loin comment faire la différence entre une vraie cannibalisation et un faux positif.
Pourquoi la cannibalisation apparaît-elle ?
Personne ne crée de la cannibalisation volontairement. Elle s’installe petit à petit, souvent avec les meilleures intentions du monde. Voici les situations que je rencontre le plus souvent en audit.
Un blog qui grossit sans fil conducteur
C’est le cas de notre artisan vu plus haut et c’est de loin le plus fréquent. Le blog existe depuis 4 ou 5 ans, plusieurs personnes ont écrit dessus (le dirigeant, un stagiaire, une agence, puis une autre…) et personne n’a jamais fait l’inventaire de ce qui était déjà publié. Chacun écrit sur ce qui lui semble pertinent sur le moment et les sujets finissent par se recouper.
Les pages catégories face aux articles de blog
Grand classique en e-commerce. Vous avez une catégorie « Chaussures de randonnée femme » et, pour la pousser, vous publiez un article « Les meilleures chaussures de randonnée femme en 2026 ». Sur le papier, l’idée est bonne. Sauf que l’internaute qui tape cette requête veut comparer puis acheter et vos deux pages répondent à cette même attente. Google doit choisir… et il ne choisit pas toujours celle qui vous rapporte de l’argent.
Les pages locales qui se marchent dessus
Je vais prendre un exemple que je connais bien. Une agence optimise sa page d’accueil sur « agence SEO La Rochelle » puis crée une page service « Référencement naturel à La Rochelle ». Les deux pages visent la même cible, dans la même ville, pour la même prestation. C’est typiquement le genre d’erreur qu’on fait sur son propre site en voulant trop bien faire (on a tous un cordonnier mal chaussé en nous :-)).
Les pages tags et archives de WordPress
Celle-ci passe souvent sous les radars. Vous taguez tous vos articles « isolation », WordPress crée automatiquement une page /tag/isolation/ qui liste ces articles. Si elle est indexée, elle peut très bien se positionner à la place de votre article de fond. Même logique pour les pages auteurs ou les archives par date.
Les contenus produits à la chaîne avec l’IA
Avec l’IA, publier 30 articles par mois est devenu facile. Le problème, c’est qu’elle n’a aucune idée de ce que contient déjà votre site. Demandez-lui 30 idées sur l’isolation et vous aurez « Isoler ses combles perdus », « Isolation des combles : les étapes » et « Comment bien isoler ses combles », soit trois articles pour une seule intention.
Un maillage interne contradictoire
Dans un article, l’ancre « isolation des combles » pointe vers votre page service. Dans un autre, la même ancre pointe vers votre guide. Vous envoyez à Google deux signaux opposés sur la page qui doit se positionner. Multipliez cela par 50 articles et vous comprenez pourquoi il hésite.
Une refonte mal gérée
Nouveau site, nouvelles URL… mais les anciennes pages sont toujours en ligne ou toujours indexées. Vous vous retrouvez avec deux versions d’un même contenu qui coexistent dans Google, parfois pendant des mois sans que personne ne s’en rende compte.
Détecter la cannibalisation avec la Google Search Console
La Search Console a un énorme avantage sur tous les outils payants : ce sont les données de Google lui-même, pas une estimation. Vous voyez exactement quelles URL de votre site sont sorties sur quelle requête, et combien de fois. C’est gratuit, autant en profiter.
Avant de commencer, réglez la période sur 3 mois minimum, idéalement 6 mois. Sur 7 jours, vous n’aurez pas assez de données pour tirer des conclusions.
La méthode par requête
C’est le point de départ, à utiliser quand vous avez un doute sur un mot-clé précis.
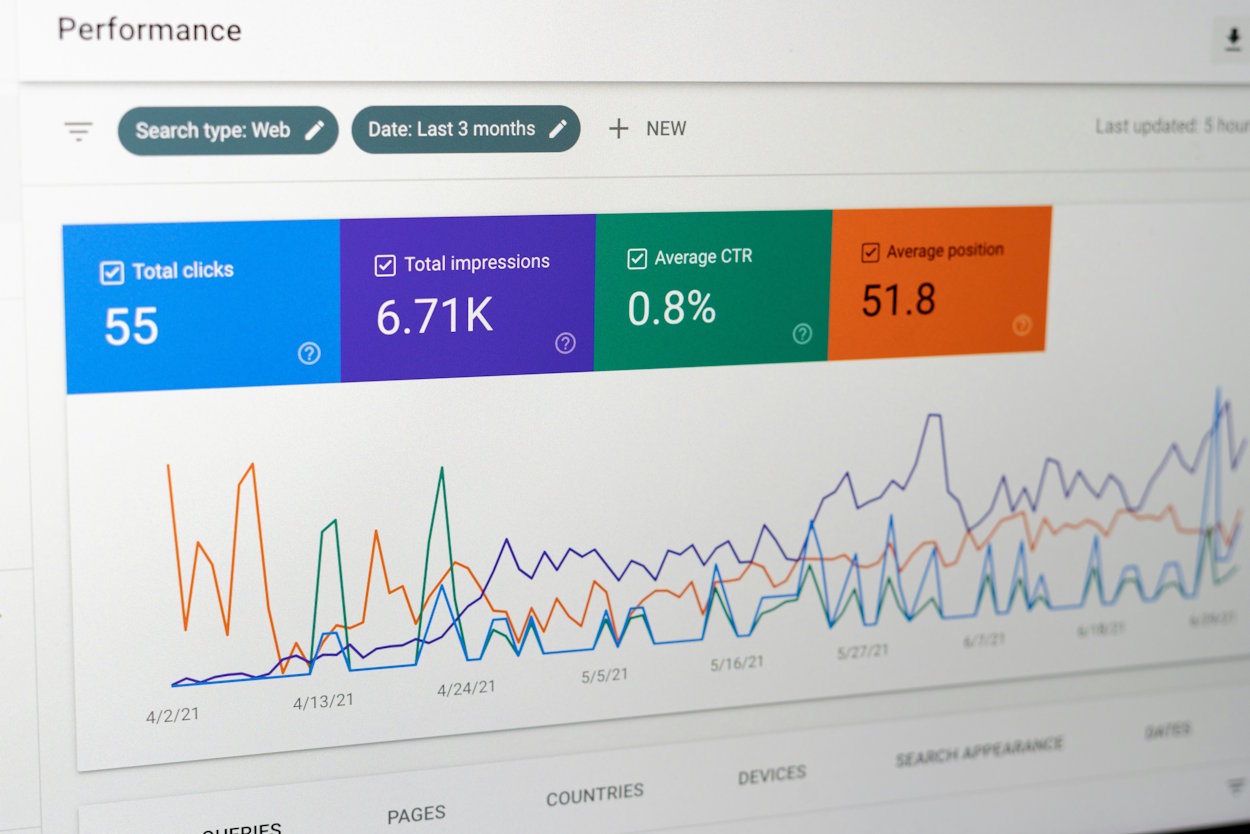
Allez dans Performances > Résultats de recherche, cliquez sur « Ajouter un filtre » puis « Requête » et choisissez « Requête exacte ». Tapez votre mot-clé, par exemple « isolation combles ». Cochez ensuite les 4 métriques en haut (clics, impressions, CTR, position moyenne) et descendez jusqu’aux onglets sous le graphique : cliquez sur « Pages ».
Si une seule URL apparaît, tout va bien. Si vous en voyez plusieurs avec des impressions, vous tenez une piste. Voici ce que cela pourrait donner pour notre artisan :
| Page | Clics | Impressions | Position moyenne |
|---|---|---|---|
| /blog/comment-isoler-ses-combles/ | 12 | 4 300 | 16,2 |
| /blog/isolation-combles-guide-complet/ | 9 | 3 900 | 17,8 |
| /tag/isolation/ | 1 | 600 | 31,5 |
Trois URL, des impressions réparties, des positions médiocres partout : c’est le schéma typique.
La méthode par page
Ici, on part de l’autre sens. Utile quand une page qui marchait bien commence à décliner sans raison apparente.
Filtrez sur « Page » > « URL exacte » avec l’URL concernée, puis ouvrez l’onglet « Requêtes ». Notez les 10 à 15 requêtes qui génèrent le plus d’impressions. Faites ensuite la même chose avec la page que vous soupçonnez d’être en concurrence. Si les deux listes se ressemblent fortement, vos pages travaillent sur le même terrain.
Petite astuce : depuis l’onglet « Pages » de la méthode précédente, un clic sur une URL ajoute directement le filtre. Vous passez d’une vue à l’autre en 2 secondes.
Lire les bons signaux
Plusieurs URL sur une requête, c’est un indice, pas une preuve. Voici ce que je regarde pour confirmer :
- La répartition des impressions : une page à 4 000 impressions et l’autre à 30, ce n’est pas vraiment un partage. Deux pages à volume comparable, c’est beaucoup plus parlant.
- L’alternance dans le temps : filtrez la requête et une première URL, regardez la courbe de position, puis faites pareil avec la seconde. Si l’une disparaît quand l’autre apparaît, Google hésite entre les deux.
- La date de publication : utilisez l’option « Comparer » sur deux périodes, avant et après la mise en ligne d’un nouveau contenu. Si l’ancienne page a perdu des impressions au moment où la nouvelle en a gagné, vous avez votre coupable.
- Un CTR anormalement bas pour la position : une page en 6e position avec 0,5 % de CTR peut signaler que Google affiche tantôt une URL, tantôt l’autre, sans jamais en installer une durablement.
Passer à l’échelle
La méthode manuelle fonctionne très bien pour vérifier 5 ou 10 mots-clés. Pour un site de 300 pages, oubliez, vous y passeriez la semaine. Et l’export de l’interface est limité à 1 000 lignes, ce qui ne suffit pas pour un audit complet.
Trois solutions selon votre niveau :
- Search Analytics for Sheets : une extension Google Sheets gratuite qui récupère les données via l’API. Vous demandez les dimensions « Requête » et « Page » et vous obtenez un tableau complet, bien au-delà des 1 000 lignes.
- Looker Studio : avec le connecteur Search Console, choisissez la table « Impression de l’URL ». Créez un tableau avec la requête en dimension et le nombre de pages distinctes en métrique, puis filtrez pour ne garder que les requêtes associées à 2 pages ou plus.
- L’export BigQuery : réservé aux gros sites, mais c’est la solution la plus complète si vous avez des dizaines de milliers de requêtes.
Pour éviter de vous noyer, filtrez avant d’analyser. Je retire systématiquement les requêtes de marque (votre nom d’entreprise fait forcément sortir plusieurs pages) et celles qui ont moins de 100 impressions sur la période. Le filtre en expression régulière de la Search Console est très pratique pour isoler une thématique : combles|grenier vous remonte toutes les requêtes qui contiennent l’un ou l’autre de ces mots.
Compléter l’analyse avec d’autres outils
La Search Console a un angle mort : elle ne vous montre que les pages qui ont déjà obtenu des impressions. Une page publiée il y a 15 jours, ou tellement mal positionnée qu’elle n’apparaît jamais, passe sous le radar. D’autres outils permettent de combler ce trou et de confirmer ce que vous avez trouvé.
La commande site: de Google
C’est le test le plus rapide et il ne coûte rien. Tapez dans Google site:votresite.fr isolation combles et regardez ce qui remonte. Vous obtenez toutes les pages que Google associe à ce sujet sur votre site, y compris celles qui ne génèrent aucune impression.
Pour aller plus loin, ajoutez des guillemets autour de l’expression (site:votresite.fr "isolation des combles") ou utilisez intitle: pour ne cibler que les pages qui ont ces mots dans leur title. Vous seriez surpris du nombre de pages oubliées qu’on retrouve comme ça.
Attention quand même : l’ordre des résultats d’une commande site: ne reflète pas le classement réel. C’est un outil d’inventaire, pas de positionnement.
Ahrefs et Semrush
Ces outils ont un gros avantage : ils proposent des rapports dédiés qui font le travail de croisement à votre place.
Dans Ahrefs, allez dans Site Explorer > Mots-clés organiques et activez l’option qui n’affiche que les mots-clés positionnés sur plusieurs URL. En cliquant sur un mot-clé, l’historique de position vous montre aussi quand Google a changé de page. Dans Semrush, le module Position Tracking intègre directement un onglet « Cannibalisation » avec un score par mot-clé suivi.
Autre intérêt : l’historique. Si vous n’avez connecté la Search Console que récemment, ces outils remontent parfois bien plus loin.
Gardez simplement en tête que ce sont des estimations. Comme on l’a vu dans notre article sur le netlinking, les données de trafic estimé ont leurs limites. Je m’en sers pour repérer des pistes, jamais pour trancher seul.
Screaming Frog
Ici, on ne regarde plus les positions mais la structure du site. Screaming Frog crawle toutes vos pages comme le ferait Google (gratuit jusqu’à 500 URL) et permet de repérer les causes techniques :
- Title et H1 en doublon : les onglets « Page Titles » et « H1 » ont un filtre « Duplicate ». Deux pages avec le même title, c’est quasiment une invitation à la cannibalisation.
- Contenus trop proches : activez la détection des quasi-doublons dans Configuration > Content > Duplicates. L’outil vous indique les pages dont le texte se ressemble au-delà d’un seuil (90 % par défaut).
- Pages indexables qui ne devraient pas l’être : les pages tags, auteurs ou archives apparaissent dans le crawl et vous voyez immédiatement si elles sont en index.
- Ancres internes : l’export Bulk Export > Links > All Inlinks vous liste tous vos liens internes avec leur ancre. Filtrez sur « isolation des combles » et vous saurez exactement vers quelles pages cette ancre envoie.
En croisant ces outils avec la Search Console, vous avez une liste solide de cas suspects. Mais avant de foncer tête baissée, il faut faire le tri, car tous ne sont pas de vrais problèmes.
Les faux positifs à ne pas confondre
Une liste de requêtes avec plusieurs URL, c’est une liste de suspects, pas de coupables. Sur les audits que nous réalisons, une bonne partie des cas remontés par les outils ne nécessite aucune action. Toucher à une page qui fonctionne, c’est prendre le risque de casser quelque chose pour rien. Le double positionnement en haut de page et les intentions différentes, on les a déjà vus en début d’article. Voici les autres pièges.
Les sitelinks
Vous tapez le nom d’un service et Google affiche votre page principale avec 4 liens en dessous (contact, tarifs, réalisations…). Pour la Search Console, chacune de ces URL a obtenu une impression sur la requête. Vous allez donc voir 5 pages sur un même mot-clé alors qu’il n’y a qu’un seul résultat, le vôtre, plus visible que les autres. Signe qui ne trompe pas : toutes ces URL affichent la même position moyenne ou presque.
Les pages qui disparaissent après une redirection
Vous avez fusionné deux pages il y a 3 semaines ? L’ancienne URL peut continuer à afficher des impressions pendant un moment, le temps que Google prenne en compte la redirection. Avant de vous alarmer, vérifiez la date de la dernière impression de l’ancienne page : si la courbe tend vers zéro, laissez faire le temps.
Les requêtes larges où Google cherche encore
Sur une requête très générique comme « isolation », l’intention n’est pas claire : l’internaute veut-il un prix, une technique, un artisan, des aides ? Google teste alors plusieurs pages de votre site, et de vos concurrents, pour voir laquelle satisfait le mieux. Voir 3 de vos URL tourner sur ce type de requête est normal. Ce n’est pas votre site qui est en cause, c’est la requête qui est floue.
Les pages filles d’un cocon sémantique
Si vous avez construit une page pilier sur l’isolation des combles et des pages filles sur des sujets précis (combles perdus, combles aménagés, isolation par soufflage…), ces dernières vont parfois apparaître sur le mot-clé principal, en 40e ou 50e position. C’est logique, elles traitent du même univers. Tant que la page pilier reste bien installée et que chaque page fille performe sur sa propre longue traîne, l’architecture fait exactement ce qu’on lui demande.
Les fluctuations d’une mise à jour Google
Pendant une core update, Google rebat les cartes et les pages changent de position dans tous les sens pendant 2 à 3 semaines. Une alternance entre deux URL observée pendant cette période ne veut rien dire. Attendez que les choses se stabilisent avant de relancer votre analyse.
La duplication technique
Une même page accessible avec et sans le « / » final, en version avec paramètres (?utm_source=…) ou avec et sans www : ce n’est pas de la cannibalisation au sens éditorial. C’est un problème technique de duplication, qui se règle différemment.
Mon test avant d’agir tient en trois questions : vos pages ont-elles des positions qui changent régulièrement de main ? Les impressions sont-elles réparties de façon comparable ? Le phénomène dure-t-il depuis plus d’un mois ? Trois oui, et vous avez une vraie cannibalisation. Il reste à décider quoi en faire.
Fusionner, différencier ou conserver : comment décider ?
Vous avez confirmé une vraie cannibalisation, place à l’action. Il n’existe pas de solution universelle : tout dépend du contenu des pages, de leurs performances et de ce qu’elles apportent à votre site. Voici comment je tranche.
Fusionner (et rediriger en 301)
C’est la solution à privilégier quand vos pages répondent à la même intention, avec des contenus proches, et qu’aucune ne se démarque. Notre artisan et ses deux articles sur l’isolation des combles en sont le parfait exemple.
La première étape consiste à choisir la page que vous gardez. Je regarde dans l’ordre :
- Les backlinks : la page qui reçoit le plus de liens externes de qualité part avec un avantage, inutile de perdre ce jus SEO.
- Les clics dans la Search Console : à backlinks équivalents, gardez celle qui génère déjà du trafic.
- L’URL : entre /blog/comment-isoler-ses-combles/ et /blog/2023/05/isolation-combles-v2/, le choix est vite fait.
Ensuite, vient le travail de fond. Il ne s’agit pas de coller les deux textes l’un sous l’autre ! Reprenez la structure de la page conservée, intégrez les passages intéressants de l’autre (une FAQ, un tableau de prix, un retour d’expérience), supprimez les redites et mettez à jour ce qui a vieilli. L’objectif est d’obtenir une page meilleure que les deux précédentes.
Côté technique, trois actions :
- Mettre en place une redirection 301 de l’URL abandonnée vers celle conservée.
- Modifier tous les liens internes qui pointaient vers l’ancienne URL pour qu’ils aillent directement vers la nouvelle. Une redirection fonctionne, un lien direct, c’est mieux.
- Retirer l’ancienne URL du sitemap.
Si vous avez acheté des liens vers la page supprimée, demandez à l’éditeur de modifier l’URL. Beaucoup acceptent sans difficulté et vous récupérez un lien direct plutôt qu’un lien redirigé.
Différencier
Parfois, les deux pages ont chacune leur raison d’exister, mais elles sont mal ciblées. Plutôt que d’en supprimer une, on la repositionne sur une intention différente.
Reprenons l’exemple e-commerce de la catégorie « Chaussures de randonnée femme » et de l’article comparatif. Plutôt que de garder un article qui vise l’achat comme la catégorie, réorientez-le vers « Comment choisir ses chaussures de randonnée quand on débute ? ». L’article devient informationnel, il répond à une autre question et il renvoie naturellement vers la catégorie pour passer à l’achat.
Concrètement, différencier une page demande de retravailler :
- Le title et le H1, pour qu’ils ciblent clairement la nouvelle intention.
- L’introduction, qui doit annoncer le nouvel angle dès les premières lignes.
- Les mots-clés secondaires et les intertitres.
- Les passages qui empiètent sur l’autre page : supprimez-les et remplacez-les par un lien vers elle.
- Les ancres internes qui pointent vers chaque page, pour qu’elles correspondent à leur nouveau positionnement.
C’est plus long qu’une fusion, mais vous gagnez une page qui travaille sur de nouvelles requêtes au lieu de doublonner l’existant.
Conserver
On a déjà vu qu’un double positionnement en haut de page ne se touche pas. Il existe un autre cas où il vaut mieux ne rien faire : quand la cannibalisation ne concerne qu’une requête secondaire alors que chaque page génère l’essentiel de son trafic sur ses propres mots-clés. Fusionner pour régler un problème sur une requête à 200 impressions, et perdre au passage des centaines de clics sur la longue traîne, serait une très mauvaise affaire.
Dans ce cas, je me contente d’ajuster le maillage interne pour indiquer à Google quelle page doit sortir sur la requête concernée, puis je surveille l’évolution sur quelques semaines.
Les cas particuliers : canonical, noindex et suppression
Certaines pages doivent rester en ligne pour vos visiteurs sans pour autant chercher à se positionner.
- La balise canonical : elle indique à Google quelle version d’une page il doit considérer comme la référence. C’est la solution pour la duplication technique vue plus haut et pour les variantes produits (une même chaussure déclinée en 5 couleurs avec chacune son URL). Attention, c’est une indication et non une obligation : Google peut l’ignorer si les pages sont trop différentes.
- Le noindex : la page reste accessible mais sort de l’index. C’est idéal pour les pages tags, auteurs et archives de WordPress, ou pour une landing page Google Ads quasi identique à votre page service.
- La suppression : une page sans trafic, sans backlinks et sans intérêt pour vos visiteurs n’a aucune raison de rester en ligne. Un code 410 indique à Google qu’elle a définitivement disparu.
Une règle à respecter : ne mettez jamais un noindex et une canonical sur la même page. Vous envoyez deux signaux contradictoires à Google.
Le tableau récapitulatif
| Situation | Action | Point de vigilance |
|---|---|---|
| Même intention, contenus proches, aucune page ne performe | Fusionner + 301 | Garder la page avec le plus de backlinks et de clics |
| Deux sujets légitimes mais mal ciblés | Différencier | Retravailler title, H1, angle et ancres internes |
| Chaque page performe sur ses propres requêtes | Conserver | Ajuster le maillage interne et surveiller |
| Variantes produits, duplication technique | Canonical | Les pages doivent être réellement similaires |
| Pages utiles aux visiteurs mais pas au SEO | Noindex | Jamais de canonical en parallèle |
| Page sans trafic, sans lien, sans intérêt | Suppression (410) | Vérifier l’absence de backlinks avant |
Quelle que soit l’action choisie, retournez dans la Search Console 4 à 6 semaines plus tard. C’est le seul moyen de savoir si Google a bien compris le message.
Une page forte vaut mieux que trois pages moyennes
La cannibalisation n’est pas une pénalité de Google. C’est surtout un gaspillage de jus SEO et de temps, qui touche en priorité les sites les plus actifs : plus vous publiez, plus le risque augmente.
La méthode est simple : partir des données de la Search Console, confirmer avec vos autres outils, écarter les faux positifs, puis choisir l’action adaptée à chaque cas. Fusionner n’est pas toujours la bonne réponse et, parfois, ne rien toucher reste la meilleure décision.
Mon conseil : avant de rédiger votre prochain article, prenez 5 minutes pour vérifier ce qui existe déjà sur votre site. C’est le meilleur moyen de ne pas recréer le problème que vous venez de régler.
Vous soupçonnez vos pages de se faire concurrence sans savoir par où commencer ? Nous pouvons réaliser un audit de votre site et vous dire précisément quelles pages retravailler en priorité.